LLM 知道一点 bug 在哪,但这没让 fuzzing 变快 [llm-guided-fuzzing]
LLM 知道一点 bug 在哪,但这没让 fuzzing 变快 [llm-guided-fuzzing]
技术报告,2026 年 10 月。我想用语言模型的隐藏状态告诉覆盖率引导的 fuzzer 该把时间花在哪里,结果大多是负面的。
读 LLM agent 找 bug 的轨迹时,我发现 agent 经常在写出第一个测试之前就说出了 bug 在哪,这让我很意外。它读完一个函数,指出某个用作下标的长度从来没有和缓冲区大小比较过,然后才写测试去证明。既然模型能从代码里看出这些,fuzzer 应该也能用上。AFL、libFuzzer 这类覆盖率引导的 fuzzer 对所有新覆盖一视同仁,哪怕只有一个算起来很便宜的“这个函数像有 bug”的分数,也能告诉它把变异花在哪里。
于是我写了 llmfuzz。它读取语言模型在 C/C++ 程序每个函数上的隐藏状态,换算成“像有 bug”的分数,在分数高的地方多花预算。这样做没有让 fuzzing 变快,之后的大部分实验都是想从模型里拿到更强的信号。我换过更大的模型,加过调用图和 AST 上下文,也让模型先推理或先写注释再回答。最后我在模型发布之后才修复的 bug 上做了测试,这些 bug 模型不可能背下来。
模型确实知道一点 bug 在哪,在新近的 bug 上这也不是记忆。但这点信息很少。同一个函数有 bug 时,分数比修复后高一些,可不同函数之间的差别比这大得多,连“函数越长越可疑”这条简单规则都排得比它好。在我试过的 bug 上,就算预测完全准确,fuzzer 最多也只能快两倍左右,因为 fuzzer 很早就能跑到有 bug 的函数,大部分时间都花在找能触发 bug 的输入上。
摘要
- 基于 Qwen3-4B 隐藏状态的 probe 区分长度相近的有漏洞和无漏洞函数,AUC 是 0.57。在 Google fuzzer-test-suite 的 13 个已知 bug 上,它把有 bug 的函数排在中位第 27 百分位,只按函数大小排是第 15。
- 按 LLM 分数加权没有让 Linux 上的 fuzzing 变快。在两台 Linux 机器上,首次崩溃时间分别是不加权时的 1.00× 和 1.58×(各目标中位数的几何平均),只按函数大小加权则是 0.35×。唯一一次大幅提速是 macOS 上的 8 倍,来自 LLM 碰巧排在第 2 的一个函数。
- 就算排名完全正确,最多也只快 2 倍左右。把真正有 bug 的函数排在第一,woff2 找到崩溃快了 1.9 倍,lcms 没有变快;其余函数的分数一旦随机,连这点收益也没了。
- 上下文没有用。在 4B 到 27B 的四个模型上,十种上下文(调用者、被调用者、调用栈、按 AST 挑选的定义、参数切片等)都不比同一文件里等长的随机代码好。
- 先推理有一点用。让 Qwen3.6-27B 先给函数写一段注释,它会把 bug 排得更靠前(中位百分位从 35 到 20),换成给另一个函数写的注释反而更差(50)。所有推理方式都没有胜过按大小排序,而且 27B 会在推理里直接认出著名的 bug。
- 在模型发布之后提交的 148 个单函数修复上,Qwen3.6-27B 有 76% 的时候给有 bug 的版本打分更高,代码量和 if 检查的多少都解释不了这一点。但它自己的 Yes/No 回答,只有 11% 的配对两个版本都答对。
llmfuzz 是怎么做的
用 J-lens 给代码打分
llmfuzz 按函数把程序切成片段,超过 150 行的函数再切成每段 150 行。每个片段在模型里过一遍,末尾接一个审查问题:
// File: cmsintrp.c
... code of the chunk ...
/* Code review. Q: Is there a bug in the function above? A:
llmfuzz 不让模型真的回答,只在最后一个位置读 Jacobian lens(J-lens)。J-lens 出自 Anthropic 的 Verbalizable Representations Form a Global Workspace in Language Models(arXiv:2607.15495)。它用最后一层对某一层的平均 Jacobian \(J_\ell = \mathbb{E}[\partial h_{\text{final}} / \partial h_\ell]\) 把这一层的残差流换算到最后一层的坐标里,再用模型自己的 unembedding 解码:\(\mathrm{lens}_\ell(h_\ell) = \mathrm{lm\_head}(\mathrm{norm}(J_\ell h_\ell))\)。大致可以理解为每一层正打算说什么。我用的是 Neuronpedia 为 Qwen3 和 Qwen3.6 拟合好的 lens。
我从 lens 里取两种分数。第一种不用训练,是 \(\log P(\text{yes}) - \log P(\text{no})\) 在最后四分之一层上的平均,下文叫零样本分数。第二种只有 Qwen3-4B 有:一个 logistic 回归 probe,输入是 12 层上 179 个概念 token(“overflow”“bounds”“unchecked”等)的 lens 概率,用 PrimeVul 里的 3,000 个函数训练。PrimeVul 是从漏洞修复提交里提取的 C/C++ 函数数据集。训练时,每个有漏洞的函数都配一个同项目、长度相差不超过 15% 的无漏洞函数,免得 probe 只学会“函数长就有漏洞”。
分数怎么影响 fuzzing
fuzzer 本身是一个兼容 libFuzzer 的 SanitizerCoverage 运行时,约 1,100 行 C。llmfuzz 先在每个程序内部把分数标准化,再换算成每条边的权重 \(w = \mathrm{clip}(e^{z}, 0.5, 8)\)。权重用在两个地方。一是种子的能量,也就是它被挑去变异的机会。能量是它最先发现的那些覆盖特征的加权和 \(\sum w^{\gamma} / \sqrt{1 + \text{hits}/256}\),所以能跑到可疑代码的种子会被多变异。二是比较操作数反馈(libFuzzer 的“value profile”),只在排名前 10% 的代码里打开。每十次挑种子有一次不看权重,免得排名错了时程序其余部分完全分不到变异。没有权重文件时这两样都不起作用,所以基线就是同一个引擎。在同样的 harness、种子和预算下,这个基线和 libFuzzer 不相上下:lcms 和 pcre2 上更快,libcxxabi 上更慢,其余持平。
信号有多强?
在 PrimeVul 的测试集上,probe 比随机好,但好得不多,也不比数行数强。
| 测试集 | Probe | 零样本 | 只看长度 |
|---|---|---|---|
| 长度匹配的配对 | 0.569 | 0.548 | 0.5 |
| 自然分布 | 0.615 | 0.685 | 0.790 |
在长度匹配的配对上,只看长度是随机水平,probe 仍然高于 0.5,说明隐藏状态里有一些长度以外的信息。到了自然分布上,这点信息和长度比起来就很小了。长函数本来就更可能有漏洞,零样本分数在那里显得更好,主要是因为它和长度相关。
fuzzing 实验用的是 Google 的 fuzzer-test-suite(FTS)里的七个目标:libcxxabi、pcre2、lcms、woff2、带 Heartbleed 的 OpenSSL 1.0.1f、re2 和 libxml2。它们一共有 13 个已知的 bug 函数,每个目标切出 79 到 4,355 个片段。
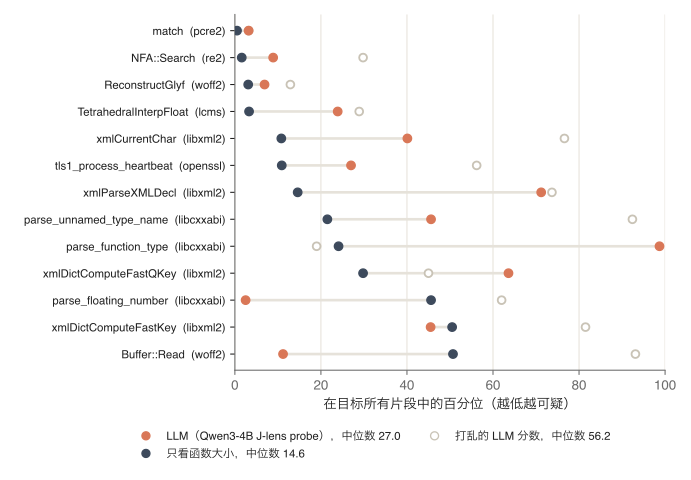
LLM 把 13 个 bug 函数中的 4 个排进了所在目标的前 10%。有时它对了而大小错了:libcxxabi 的 parse_floating_number 被 LLM 排在 79 个片段的第 2 位,按大小只排在中间。它也有错得很离谱的时候。13 个 bug 合起来看,只按大小排更好(中位百分位 14.6 对 27.0)。
用 LLM 分数加权 fuzzing
所有配置用同一个引擎、同一个二进制,只换权重文件。每次试验是一个进程,预算 900 秒,看首次崩溃时间:超时和内存耗尽也算崩溃,什么都没找到的试验记为 900 秒。每个目标的每种配置跑 6 到 10 次。
| 权重 | Linux | Linux,第二台机器 | macOS |
|---|---|---|---|
| LLM | 1.00×(2/5) | 1.58×(0/5) | 0.30×(3/3) |
| 只看大小 | 0.35×(5/5) | – | 0.86×(2/3) |
| LLM + 大小 | 1.14×(1/5) | – | 0.27×(3/3) |
| 打乱的 LLM | 1.36×(3/5) | – | 0.55×(1/3) |
| libFuzzer | 0.86×(3/5) | – | – |
macOS 上的收益几乎全部来自 libcxxabi。那里的崩溃在 parse_floating_number 里,正是 LLM 排第 2 的函数。(这是一个只在 Apple arm64 上才有的栈溢出:那里的 long double 是 8 字节,demangler 却按 16 字节解析。)在这个目标上,LLM 权重 0.6 秒就找到了 bug,不加权要 4.7 秒(Mann-Whitney U 检验,p = 0.001),也比随机打乱的权重快。lcms 上,LLM 权重在 macOS 上有帮助(351 秒对 828 秒),在 Linux 上反而拖慢了(878 秒对 486 秒)。
在 Linux 上,只按大小加权最快,在 libcxxabi(82 秒对 837 秒)和 pcre2 上差异显著。往里混入 LLM 分数会抵消掉大半:只混入四分之一,libcxxabi 就退回到了 796 秒。
权重错了,代价可能很大。有一次打乱的排名把 lcms 的能量分给了慢输入,执行速度降到十分之一(每秒 329 次对 3,168 次),10 次试验一次也没找到 bug。
另外两个更难的目标 libxml2 和 re2 各跑了 1,800 秒。在 libxml2 上,所有加权配置(LLM、打乱、大小)都比不加权好,所以那里起作用的应该是加权本身,和 LLM 的判断关系不大。LLM 排在前面的那部分代码,最后在所有配置下覆盖得一样多;权重只改变了 fuzzer 到达那里的先后顺序。
完美的排名能带来多少
排名帮不上忙,可能是因为排错了,也可能是排对了也没用。为了区分这两种情况,我用一个知道答案的 oracle 代替 LLM,它把真正崩溃的函数放到指定的名次上。最简单的设置只抬高 bug 函数,其余函数权重都一样;加噪声的设置给其余函数随机打分,每次试验重新抽。
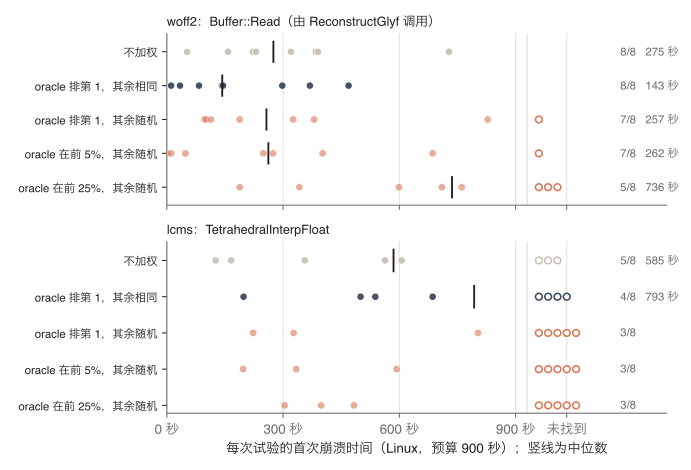
bug 函数排第一、其余相同时,woff2 的中位时间从 275 秒降到 143 秒,快了 1.9 倍,但不显著(p = 0.17);lcms 没有变快。lcms 的 bug 函数位于一个插值例程的内层循环里,把它排到最前面会在那里打开比较反馈,执行慢了 26%。
其余函数的分数一旦随机,收益就没了。bug 函数仍排第一、其余随机时,woff2 回到了 257 秒;bug 函数只是在前 25% 时,反而比不加权显著更慢(736 秒,p = 0.03)。
不加权的 fuzzing 很早就能跑到这两个函数。时间都花在凑出让缓冲区溢出的那组取值上,多变异能跑到这个函数的输入,并不能更快凑出来。用真实 bug 位置做定向 fuzzing 的研究也得出了同样的结论(见相关工作里的 LibAFLGo 和 AIJon)。所以在这些 bug 上,就算 bug 预测器完全准确,也帮不了多少。
加上下文
很多漏洞只看一个函数判断不了,下标安不安全,要看调用者传进来什么。所以我在函数前面加上上下文,在四个模型上重新排名:Qwen3-4B,以及量化到 4 bit 的 Qwen3-8B、Qwen3-14B 和 Qwen3.6-27B。调用图从 clang AST 里提取,从 fuzz harness 开始。
原始的上下文最多 3K token,有这几类:每个被调用者的开头几行,每个调用者里调用点附近的代码,一条从 harness 到该函数的调用路径,以及文件里位于该函数前面的源码。挑选过的上下文每部分最多 1.5K token,包括函数用到的宏、类型、结构体和全局变量的定义,每个调用者里计算或检查调用参数的语句(按变量名做的后向切片),被调用者的签名和注释,以及固定长度的周边代码窗口。对照组给函数配上同一文件里的随机代码,长度和定义部分相同。
| 上下文 | Qwen3-4B | Qwen3-8B | Qwen3-14B | Qwen3.6-27B |
|---|---|---|---|---|
| 被调用者 | 5–5 | 4–6 | 5–5 | 4–5 |
| 调用者 | 3–10 | 7–5 | – | – |
| 调用栈 | 4–5 | 9–2 | – | – |
| 调用栈和被调用者 | 7–6 | 8–5 | 8–4 | 7–5 |
| 文件中前面的代码 | 4–6 | 7–6 | 9–3 | 9–3 |
| 定义 | 5–6 | 5–5 | 7–3 | 5–4 |
| 调用者参数切片 | 6–4 | 6–4 | 6–3 | 5–4 |
| 定义和切片 | 7–4 | 8–5 | 10–2 | 8–4 |
| 被调用者签名 | 2–5 | 3–3 | 4–2 | 3–4 |
| 固定窗口 | 6–7 | 8–5 | 9–3 | 5–7 |
| 随机代码(对照) | 6–4 | 7–4 | 9–0 | 6–3 |
只有两格显著,都是 14B,其中一格还是随机代码。只给函数本身时,14B 对这些 bug 的排名比随机还差,所以多给什么代码几乎都能帮到它,相关不相关都一样。看起来最好的是 27B 加文件中前面的代码,中位百分位 9.3,换成固定长度的窗口后变成了 30.2。函数在文件里的位置不同,前面的代码长短也不同,9.3 多半是这个造成的假象。
这里有个容易踩的坑,我最初的分析就踩了。上下文会改变每个拿到它的片段的分数:同样长度的随机代码就能让 yes 对 no 的对数几率降低 1.5 到 2.8。有的 bug 函数抽不出上下文,分数保持原样,和分数被拉低的对比片段放在一起,就显得格外可疑。我最初就是这样比的,得出 4B 加被调用者的中位百分位是 14.6;只比较都拿到了上下文的 bug 函数和对比片段,结果是 28.7。
让模型先推理
前面读的都是一次前向传播,而让我意外的那些 agent 都是先推理再回答。也许模型要先把代码想一遍,这些知识才会出来。我用聊天格式,在同样的片段上试了三种问法。
- 直接回答。问模型“这个函数里有没有 bug(比如越界读写、释放后使用、整数溢出或逻辑错误)?只用一个词回答:Yes 或 No。”(提示词原文是英文),在回答开始的位置读 lens。
- 先思考。模型先推理,推理完在同样的位置读 lens。限制 512 token 时,几乎每条思维链都被截断了(14B 是 91%,27B 是全部),于是我用 vLLM 重新生成了完整的推理(最多 8,192 token),在推理之后读 lens。
- 先写注释。另开一次提示,让模型给函数写一段简短的注释,写明它做什么、对参数有哪些前置条件、缓冲区大小和下标范围要满足哪些不变量,并要求它不要判断代码对不对。注释放在代码上方,然后模型直接回答。对照组里,每个函数拿到的是模型给同一目标里另一个函数写的注释。
| 提问方式 | Qwen3-14B | Qwen3.6-27B |
|---|---|---|
| 直接回答 | 17.9% | 35.2% |
| 先思考,≤ 512 token | 27.8%(7–6) | 24.1%(5–8) |
| 先思考,完整推理 | 15.4%(7–6) | 18.3%(4–8)* |
| 先写注释 | 17.9%(7–5) | 20.1%(10–1) |
| 另一个函数的注释 | – | 50.0% |
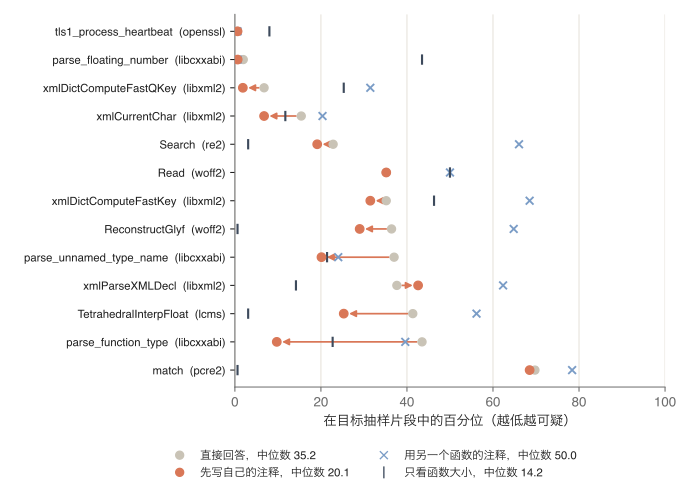
先写注释对 27B 有用。它自己写的注释把中位数从 35.2% 降到 20.1%(10 个上升,1 个下降,p = 0.01)。换成另一个函数的注释,比不加还差(50.0%;自己的对另一个函数的:11–0,p = 0.001),所以只是多一段注释并不会变好。这些注释常常直接写出了代码违反的条件。对 Heartbleed,模型写的是 payload (from message) must be <= s->s3->rrec.length - 3,正好是缺的那个检查。14B 从自己的注释里得不到任何好处。
完整推理让 14B 多了一点大小以外的信息。在这种格式下直接回答时,14B 的分数基本反映的是函数长度:扣除大小的影响后,bug 排在第 66 百分位,比随机还差。完整推理之后排到第 33 百分位(12 个上升,1 个下降,p = 0.003)。它的 Yes/No 回答也更有区分了:对 80% 的 bug 片段和大约一半的其他片段说 Yes,之前是 100% 和 86%。它在推理里说对了 Heartbleed 和 libxml2 xmlDictComputeFastQKey 的成因(下标 len - (plen + 2) 可能变成负数),其余大多数 bug 给的理由是错的。
被截断的推理对两个模型都没用,完整推理对 27B 也没用。这些方式都没有胜过按大小排序:和只按大小比,先写注释的 27B 是 8–5,完整推理的 14B 是 5–8,完整推理的 27B 也是 5–8,都不显著。
读 27B 的推理还会发现一个更麻烦的问题:在这些 bug 上,它常常是直接认出了代码。“这正是 Heartbleed。”“我找到了 LittleCMS 2.0 里一个 bug 的记载。”“这类提示通常来自一个已知 bug 的数据集。”(推理原文是英文。)13 个 FTS bug 都出自 2014 到 2017 年,上面的任何结果都可能有一部分来自记忆。
同一个函数修复前后的两个版本
为了区分“知道”和“记得”,我改用配对测试。每一对是同一个函数的两个版本,分别取自修复 bug 的那次提交之前和之后。两个版本分开问,提示完全一样。模型如果知道 bug 在哪,就应该给有 bug 的版本打更高的分,最好对它说 Yes,对修复后的版本说 No。
新 bug 有 148 对,都是 30 个活跃 C/C++ 项目(OpenSSL、curl、QEMU、FFmpeg、SQLite、PHP、radare2、libheif、Wireshark 等)里只改一个函数的内存安全修复,提交时间在 2026-05-02 到 2026-10-08 之间。Qwen3.6-27B 发布于 2026-04-21,不可能见过这些修复。我先保留提交信息写明是内存安全修复、只改一个函数且改动不超过 20 行的提交,读过提交信息后又去掉了 8 个。旧 bug 有 100 对,来自 PrimeVul 的配对测试集,每个项目最多 6 对,很可能在训练数据里。
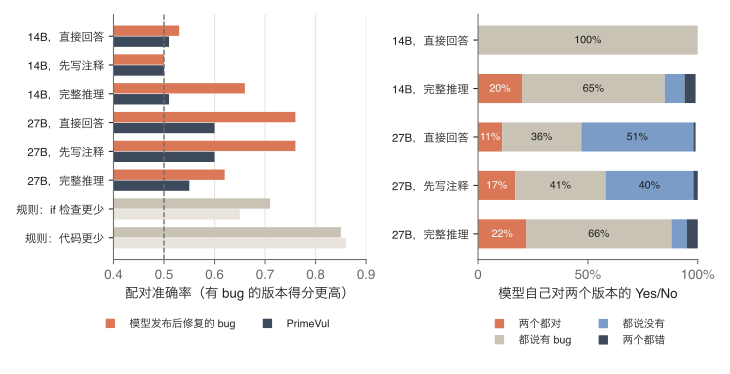
最简单的规则反而最准,因为修复会加代码:“代码少的那个版本有 bug”在两个集合上都有 85% 的正确率。这条规则只在配对测试里有用。给整个代码库的函数排序时,并没有修复后的版本可以拿来比。
27B 知道的比这条规则多,而且在新 bug 上不可能是记忆。直接回答时,它在 76% 的新 bug 配对里给有 bug 的版本打了更高分。修复不增加代码的 24 对里仍有 75%,修复不增加 if 检查的 82 对里有 73%,而那两条简单规则在这些配对上只有随机水平甚至更低。它在新 bug 上比在 PrimeVul 上(60%)好,可能是因为 PrimeVul 的标签有噪声,而新 bug 大多是局部缺了检查。14B 只有在完整推理之后才有信号(66%)。
但它的 Yes/No 回答几乎分不开两个版本。直接回答时,27B 只在 11% 的配对里两个版本都答对,51% 的配对两个都说没有 bug。完整推理之后,两个都答对升到 22%,可两个都说有 bug 也升到了 66%,有 bug 的版本得分更高的配对只剩 62%。推理主要是让模型更愿意说代码有 bug。
它两个都答对的时候,理由往往也是对的。推理后的 27B 对有 bug 的版本说 Yes、对修复后的版本说 No 的新 bug 配对有 33 个,其中大多数解释和修复对得上:OpenSSL OCSP 检查里 bs 的重复释放、libheif 里 get_width() - x0 的下溢、radare2 r_str_escape_raw 里 sz * 4 的溢出、expat xcsdup 里的整数溢出。在全部配对上,它的推理引用了修复位置某一行代码的,有 bug 的版本占 36%,修复后的版本占 14%;只算插入代码的修复(这时被引用的行两个版本里都有),差距缩小到 40% 对 29%。
所以我在轨迹里看到的现象是真的:强模型只看代码就能发现一个没见过的 bug,并且讲清楚。只是轨迹里看不出,同一个模型对没问题的代码有多少次也一样笃定。
为什么做不成更好的 fuzzer
把这些结果放在一起看,我不认为换更大的模型或更好的提示能救回这个想法。
- 同一个函数有 bug 时,模型的分数只高一点。fuzzer 却要在成千上万个不同的函数之间比较,这些函数在大小、复杂度和写法上的差别比这一点大得多。所以本报告里每个排名都输给了函数大小,模型的 Yes/No 回答单独看也没什么意义。
- 找到函数不是瓶颈。oracle 实验显示,在这些 bug 上,完美排名最多值 2 倍左右。fuzzer 很早就跑到了有 bug 的函数,剩下的工作是凑出能触发 bug 的取值。
- 权重错了的代价,可能比权重对了的收益更大。坏的排名会把 fuzzer 困在慢输入上,或者在热循环里打开昂贵的反馈;一个还算不错的排名(bug 在前 25%)就已经比不加权更慢了。
下面几种用法也许还行得通。
- 让模型提出具体的 bug(这一行,在这个条件下会出错),再用测试或 fuzzer 去证实或推翻。模型最擅长的就是这个。猜错只浪费一个测试,猜对就直接指向触发条件。
- 利用每个提交本来就有的修改前后两个版本。配对信号能不能标出引入 bug 的提交,这里没有测;就算能,oracle 实验的上限也会限制它能省下多少 fuzzing 时间。
- 让模型写输入生成器和触发条件。文献里 LLM 在 fuzzing 上明确的收益都来自这里。
相关工作
用 probe 在隐藏状态里找漏洞
在 C/C++ 漏洞检测上,probe 很弱,而且常常抓的是表面特征。Probing the Prefill(2026)在最大 27B 的模型的最后一层状态上训练 MLP probe,在 PrimeVul 上 F1 为 17.6 到 19.5,低于微调小模型的 24.5;它没有报告 AUC,也没有控制长度。Activation Probes Surface Code-Security Signals(ICML 2026 workshop)在 Python 上达到 61% 到 67% 的成对准确率,并报告以 C/C++ 为主的类别接近随机。在 SAGE(ISSTA 2026)的消融里,线性 probe 在不控制长度的 PrimeVul 上有约 74% 的平衡准确率,在按时间切分的 PreciseBugs 上约 50%。Code Correctness Is Linearly Decodable 报告的 AUC 是 0.88;我用作者公开的数据重算,只用题目难度就有 0.82,控制难度和长度之后 probe 约为 0.65。
函数级漏洞检测已接近上限
在 PrimeVul(ICSE 2025)的配对设置里(要求有漏洞的版本和修复后的版本都分类正确),GPT-4 得分 12.9%,而随机猜测是 22.7%。Weissberg 等人(ICSE 2026)发现,基于 23 个代码度量的分类器 F1 达到 20.3,最好的微调模型是 20.7,而且 LLM 的判断在因果上跟着这些度量走。在 SAGE 的表格里,前沿模型在 PrimeVul 上的 MCC 是 0.08 到 0.14,在新数据上约为 0。
上下文
Risse 等人(ISSTA 2025)发现,43% 到 52% 的真实漏洞依赖被调用的函数,40% 到 47% 依赖调用者传入的参数。直接粘贴调用者和被调用者的原始代码会让结果变差:CPRVul 的全部六种设置都退化了;在 Lira 等人(EASE 2026)的实验中,GPT-4.1-mini 在 C 上从 75.6% 降到 51.0%。VulEval 只在给出 oracle 上下文(修复同时改动的那些函数)时才有提升。挑选或摘要过的上下文有一点帮助,比如 LLMxCPG(USENIX Security 2025)和 PacVD。就我所知,此前没有工作把上下文和隐藏状态 probe 结合起来;本文里挑选过的上下文并不比随机代码好。
按 bug 可能性引导的 fuzzing
按预测的 bug 可能性引导 fuzzer,在 LLM 之前就有:V-Fuzz、TortoiseFuzz(NDSS 2020)、SAVIOR(S&P 2020)、ParmeSan(USENIX Security 2020)和 AFLChurn(CCS 2021)。LLM4Fuzz 把 LLM 给每个函数的分数乘进种子能量,和 llmfuzz 的机制几乎一样,而在它自己的消融结果里,复杂度成分比漏洞成分更有用。AIxCC 决赛中有好几个系统用 LLM 为 fuzzer 排序可疑函数(见 AIxCC SoK)。Attention Distance(ICSE 2026)用 LineVul 的注意力引导定向 fuzzing,比 AFLGo 快 3.43 倍,但没有随机或代码度量的对照。SoK: Where to Fuzz?(AsiaCCS 2024)在 1,621 个 OSS-Fuzz 崩溃上比较了目标选择方法:代码度量排得最好,LineVul 接近随机。
定位不是瓶颈
在 Magma 上使用真实 bug 位置时,LibAFLGo(EuroS&P 2025)里没有任何定向策略胜过不定向的 LibAFL。AIJon(2026)把 LLM 写的 IJON 注解放在真实的 bug 位置上,触发了 34 个 bug,而 AFL++ 是 38 个。Perera 等人(TSE 2023、TOSEM 2024)在 Java 的基于搜索的测试中,用 oracle 和受控噪声做了“缺陷预测器需要多准”的实验;fuzzing 还没有这类研究的完整版本。
LLM 在 fuzzing 里有用的地方
明确的收益都来自生成输入。G2Fuzz(USENIX Security 2025)让 LLM 编写输入生成器,再交给 AFL++ 变异,每 24 小时的模型调用花费不到 0.2 美元。目标已知时,Locus(ICSE 2026)让 LLM 合成触发谓词作为反馈,在 Magma 上快 41.6 倍。HyLLfuzz 在 fuzzer 停滞时用 LLM 代替约束求解器。这三种做法调用模型的次数都很少。反过来,用神经网络引导每一次变异,在公平的评估下并没有胜过 AFL++(Revisiting Neural Program Smoothing,ESEC/FSE 2023)。
如果你也想试
- 加一个只看大小或复杂度的基线。它在这里赢了 LLM,在文献里也经常赢。
- 加上下文时,同时加一组等长的随机代码作对照,并且只比较都拿到了上下文的片段。上下文会改变分数,把有上下文和没上下文的片段混在一起比,会比出并不存在的效果。
- 先测一个完美的预测器值多少,再去做预测器。这里的答案是 2 倍左右。
- 用模型发布之后才修复的 bug 测试,并且比较同一个函数有 bug 和已修复的两个版本,不要只给几个著名的 bug 排名次。
- 只有 13 个 bug 时,中位数会大幅摆动。27B 加定义上下文后,中位数从 27% 变成 6%,但只有 5 个 bug 上升、4 个下降。要用配对检验。
局限
- 排名和 fuzzing 结果只基于 7 个 FTS 目标里的 13 个 bug 函数。fuzzing 每次试验 900 秒(libxml2 和 re2 是 1,800 秒),每种配置 6 到 10 次,用的是我自己的引擎,没有在 AFL++ 上复现。
- 引擎的种子能量没有考虑执行时间。后来加上 AFL 的速度系数,SQLite 和 libxml2 上的吞吐提高了 2 到 11 倍;换成更强的引擎,这些 bug 会被更早找到,几种加权方式之间的快慢顺序也可能变。
- oracle 实验只有 2 个目标,每个 8 次试验。
- Qwen3-8B、14B 和 27B 都是零样本使用(没有训练 probe),并量化到 4 bit。完整推理用的 4-bit 检查点(AWQ)和打分用的不是同一个;每个函数的推理只采样一次;在 FTS 子样本上,27B 有 20% 的推理(配对测试中是 30%)达到了 8,192 token 的上限。
- lens 是在 wikitext 上拟合的。
- 新 bug 配对是根据提交信息挑的,其中少数“修复”可能只是加固;PrimeVul 的标签也已知有噪声。
关于本报告
fuzzer、分析脚本和每次试验的原始结果都在 llmfuzz 仓库里(bench/ 和 bench/results/)。lens 来自 Neuronpedia 的 jacobian-lens 合集;模型是 Qwen3 和 Qwen3.6。大部分代码是用 Claude Code 写的,大部分实验也是用它跑的。